
Gemini 4 Argon 100 万 token 怎么用?上下文、价格与长任务实践
Gemini 4 Argon 发布后,“100 万 token”和“$2/$10”成为讨论最多的两个数字。真正接入时,最容易踩坑的地方也正是这里:100 万是输入与输出合计的上下文窗口,介绍期价格不等于永久价格,长输出也不等于更高质量。本文以 Google 官方发布页和模型卡为依据,给出可执行的长任务方案。
 图:长上下文应用示意。实际配额、超时和模型 ID 以 API 文档为准。
一、先分清 4 个 token 概念
Google DeepMind 模型卡写明,Gemini 4 Argon 支持文本、图片、音频和视频输入,输入与输出合计上下文窗口最多 1M token。Google 发布博客还说,模型输出能力从此前的 64K 扩展到 1M。产品接入时,应把下面四个概念分别记录:
| 概念 | 含义 | 你需要控制的参数 |
|---|---|---|
| 输入 token | 提示词、历史对话、文件和多媒体内容 | 文件分片、检索范围、缓存 |
| 输出 token | 模型生成的回答、代码或结构化数据 | max_output_tokens、停止条件 |
| 输入+输出窗口 | 单次请求的总上下文预算 | 输入越大,可用输出越少 |
| 计费 token | 供应商实际计费的输入、输出和缓存 token | 账单、预算告警、重试 |
这意味着把 900K token 的资料放进请求后,不应再假设还能稳定得到 100K token 的完整答案;还要考虑系统指令、工具结果、思考过程和平台硬限制。中文、代码和表格的 token 比例不同,不能按“一个 token 等于一个汉字”估算。
二、$2/$10 价格怎么计算?
官方发布页给出的 introductory 价格是输入每百万 token 2 美元、输出每百万 token 10 美元,缓存输入比输入标准价低 95%。脚注同时说明,介绍期结束后会调整为输入 4 美元、输出 20 美元。因此,宣传图里的“$2/$10”应理解为阶段性价格,不能直接写成永久套餐价格。
单次请求的基础成本可以按下面的公式估算:
基础成本 = 普通输入 token × 输入单价
         + 缓存输入 token × 缓存单价
         + 输出 token × 输出单价
举例:一次请求包含 200,000 普通输入 token、800,000 缓存输入 token 和 50,000 输出 token,在介绍期按 $2/$10 粗算,普通输入为 $0.40,缓存输入为 $0.08,输出为 $0.50,合计约 $0.98。实际账单还要看平台如何计入思考 token、工具调用、批处理和失败重试,接入时应以控制台账单为准。
三、长文档不要“一次生成到底”
100 万 token 的价值在于让模型看见更多上下文,而不是鼓励一次生成一百万 token。合同、研究报告和代码库可以采用“四步法”:
- 建立索引:先生成章节、文件、证据位置和风险标签,保存为 JSON。
- 分段处理:每轮只修改一个章节或一个模块,输出固定 schema。
- 交叉复核:让第二轮只检查数字、引用、术语和相互矛盾处。
- 最终组装:在保留引用和版本号的前提下生成成稿,并由解析器检查格式。
这种方案比“一次输出完整长文”更容易断点续写、重试和审计。对于法律、金融和安全材料,还应先脱敏,再限制模型只能访问完成任务所需的资料。
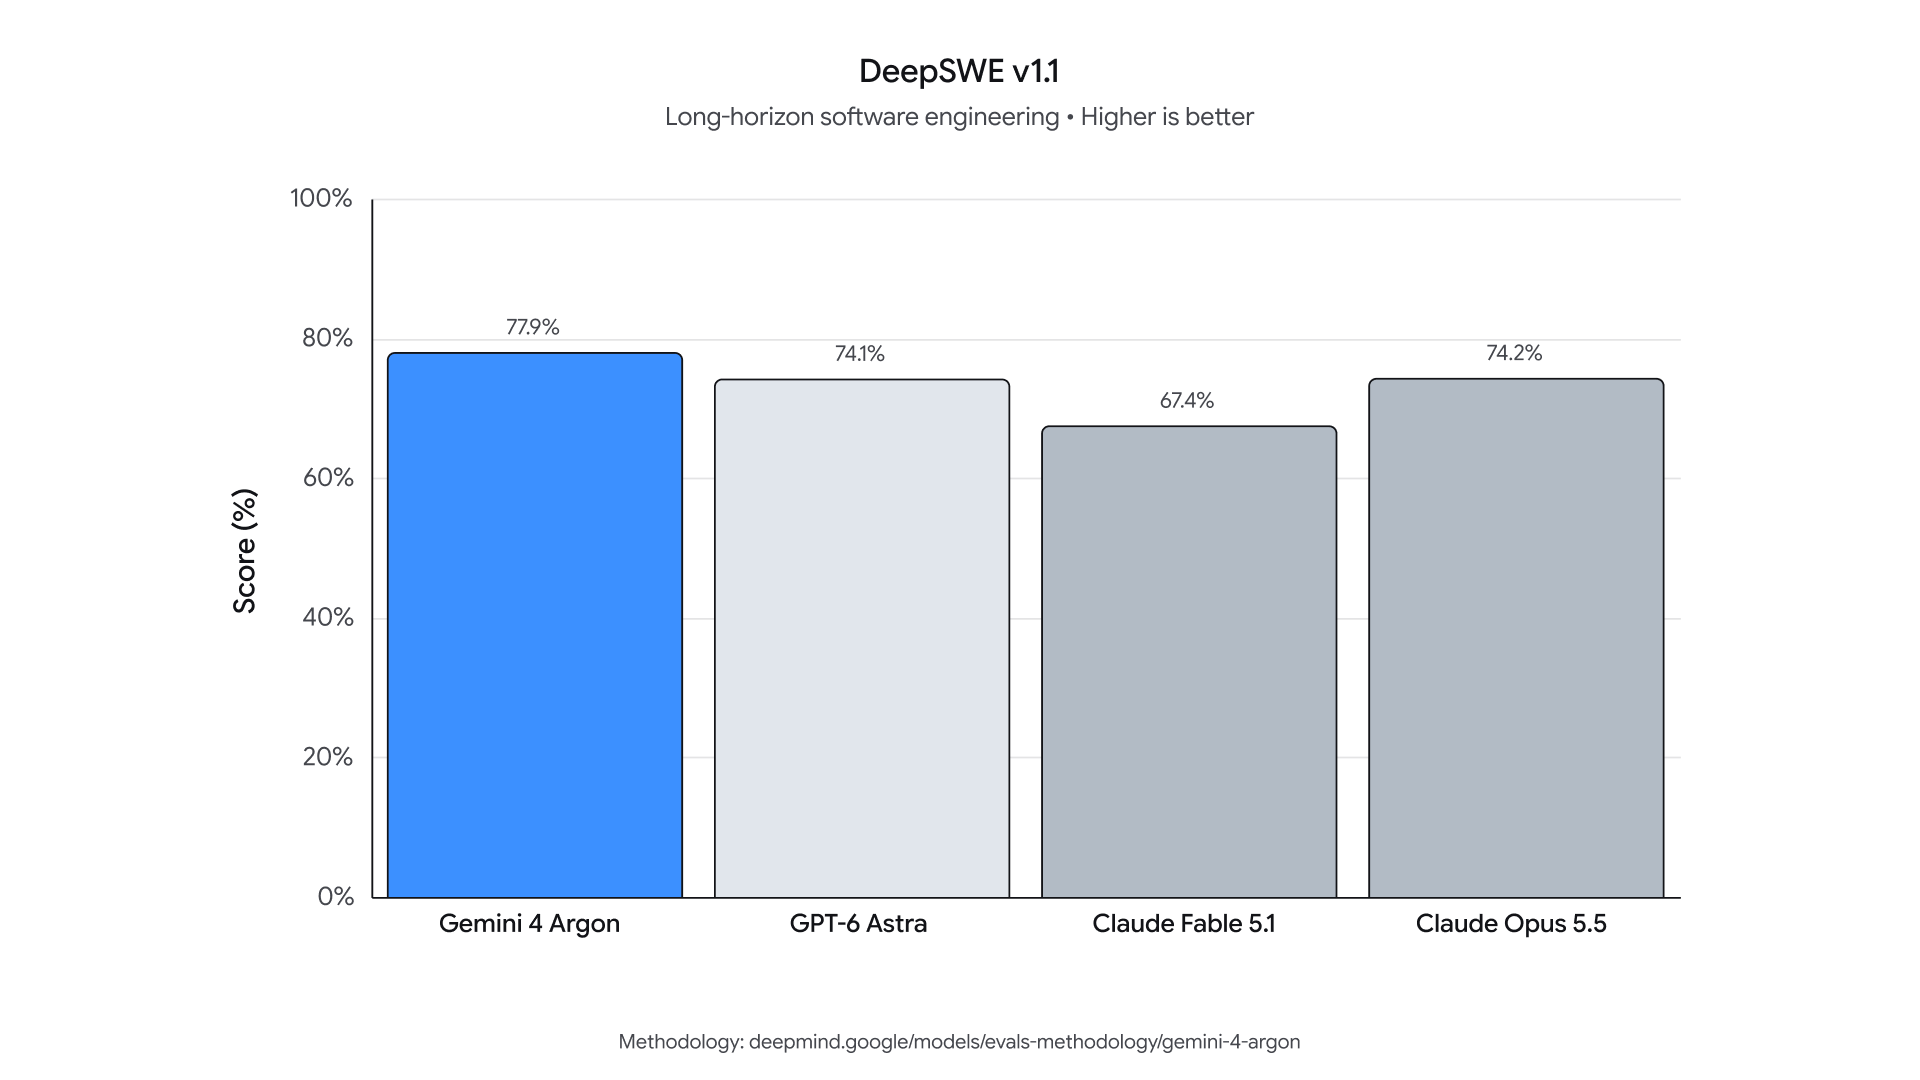 图:代码 Agent 工作流示意。每个补丁都应有测试、审查和回滚边界。
四、三类任务的推荐工作流
1. 代码库迁移
把仓库目录、构建命令、目标版本和禁止修改的文件写进任务说明。先要求模型生成迁移计划和风险清单,再让它以小提交修改;每次只开放必要的写权限,并在本地运行测试。Google 官方披露 Argon 已参与 C/C++ 到 Rust 的大规模迁移,但官方案例仍经过自动化与人工审计,不能理解为无需审查。
2. 合同和研究资料
将 PDF、表格和会议记录按来源编号,要求每个结论附文件名、页码或段落引用。对“未找到证据”的问题,规定模型输出 unknown,不要让它用常识补齐。最终报告应由专业人员复核,模型只提供检索和起草支持。
3. 批量 JSON 或 SQL
使用分页、幂等任务 ID 和 schema 校验;单批失败只重试当前分片。即便窗口足够大,也要设置单批最大输出、超时和日预算,避免一条异常记录让整个作业持续生成。
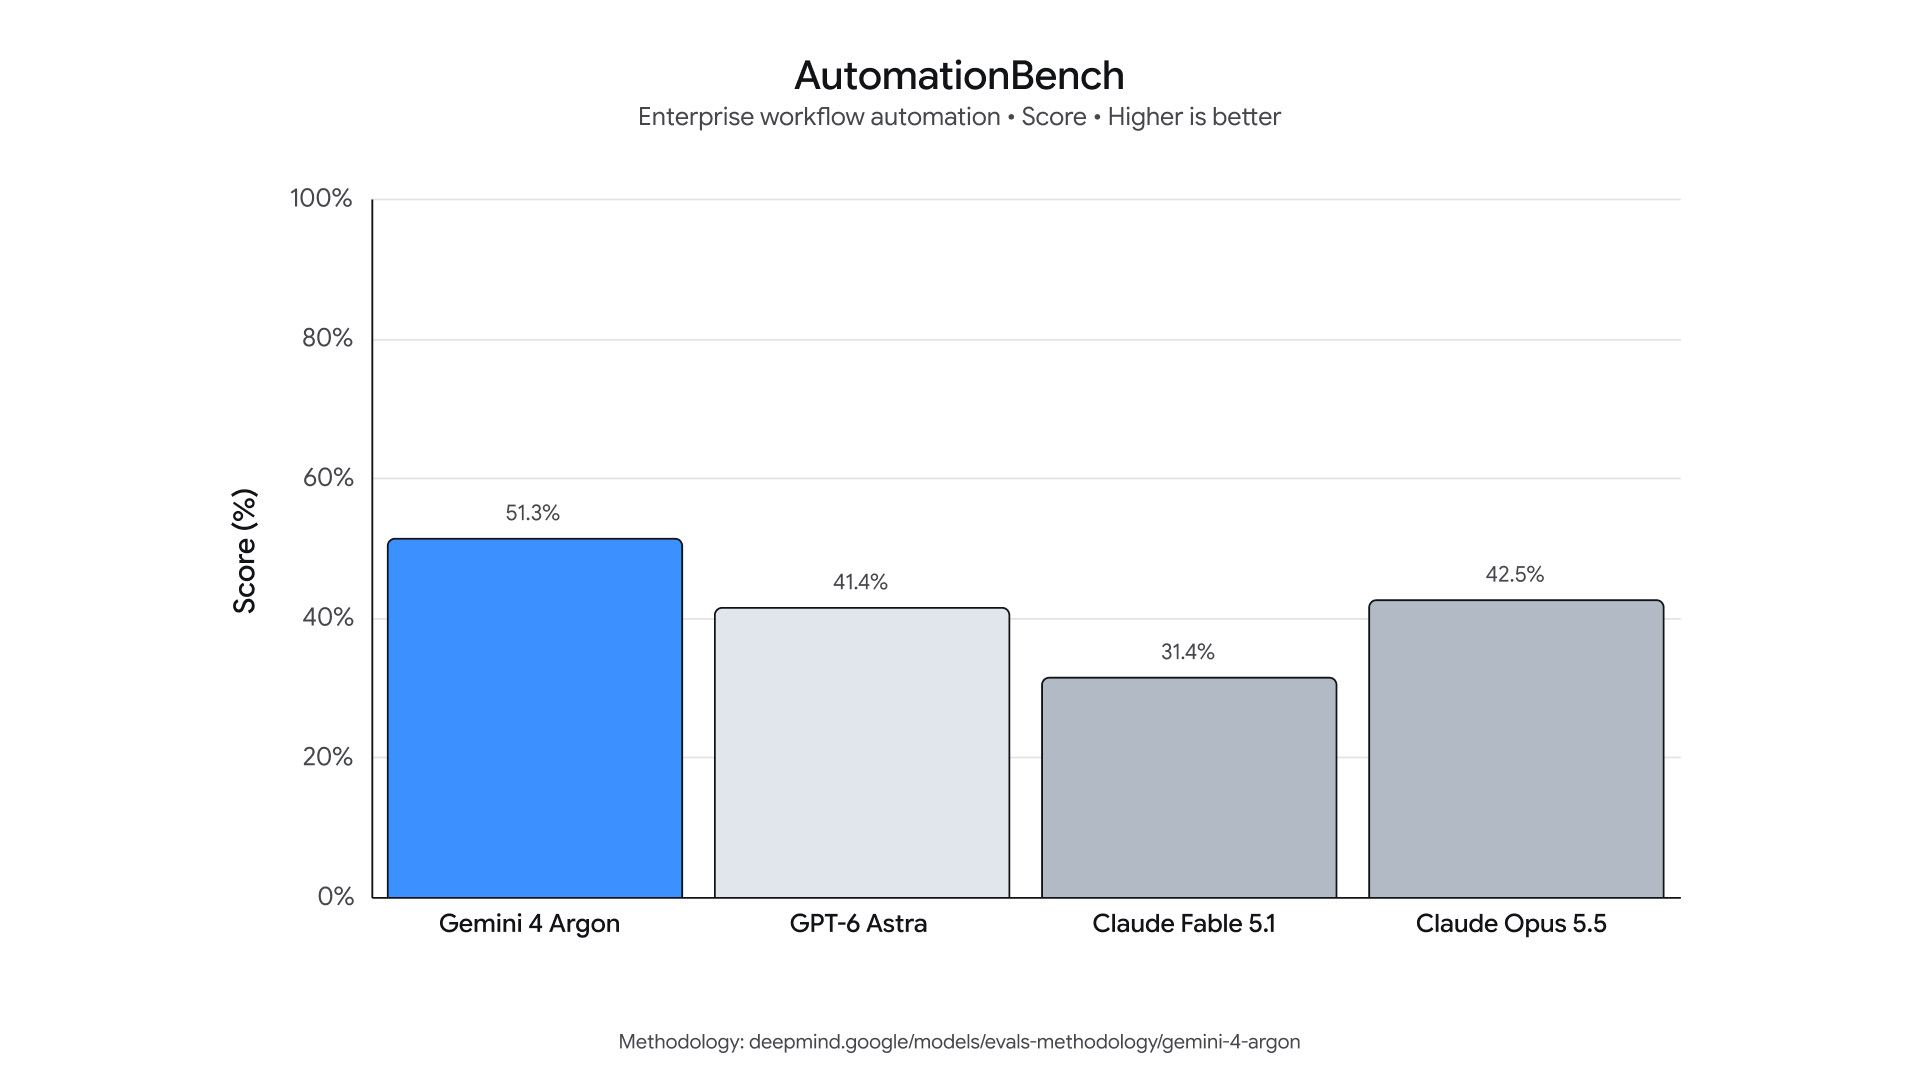 图:Agent 批处理示意。付款、删除、发信和权限变更应保留人工确认。
五、接入前的 8 项检查
- 在 Gemini API 模型列表 确认模型 ID 和生命周期。
- 记录普通输入、缓存输入和输出 token 的实际账单。
- 为 10K、100K 和更长上下文分别建立回归样本。
- 设置输出上限、超时、重试次数和每用户预算。
- 对代码、JSON、SQL 做语法解析,不直接执行原始输出。
- 对长视频和图表任务保存原始文件、提示词和模型版本。
- 检查数据保留、区域、权限和第三方聚合平台条款。
- 对高风险任务安排人工复核和可回滚流程。
常见问题
Gemini 4 Argon 的 100 万 token 能装下整套代码库吗?
可能装下,但能否稳定完成任务取决于代码重复度、工具结果、输出预算和平台限制。更可靠的方式是按模块建立索引,再让模型按提交处理。
缓存输入真的便宜 95% 吗?
官方发布页给出的是相对输入标准价的 95% 折扣。缓存命中条件、有效期和具体 API 计费仍要看价格页及账单,不应自行假设所有历史对话都能命中。
长上下文会不会降低准确率?
会有这种可能。资料越多,噪声、重复和冲突也越多。应通过检索范围、证据引用、分段复核和人工抽查控制质量。
结语
Gemini 4 Argon 的 1M 上下文更适合“看全资料、分步完成、可追溯交付”的工作流。若要了解整体发布信息,可阅读站内的 Gemini 4 Argon 官方发布解读;若要做模型对比,应先用自己的脱敏任务测量成功率、延迟、重试和总成本。价格与可用性以 Google 官方博客 和 Gemini API 价格页 为准。
免责声明:本文是技术选型信息,不构成法律、财务或安全建议。上传企业资料前请完成脱敏与授权检查,并遵守当地法律法规和服务条款。